Harnais d’évaluation RAG
Vérifiez avec le même jeu de questions si une mise à jour de votre assistant IA a dégradé ses réponses
Rassemblez questions et réponses attendues dans un CSV, et faites répondre l’assistant de la même façon avant et après une mise à jour. Les questions dégradées depuis la dernière fois apparaissent en tête d’un rapport en japonais. C’est un programme Node.js qui tourne sur votre machine : il n’y a donc pas de démo interactive sur cette page. Les écrans ci-dessous sont le rapport de l’exemple (npm run demo:diff), consultable après l’achat avant même de saisir une clé d’API.
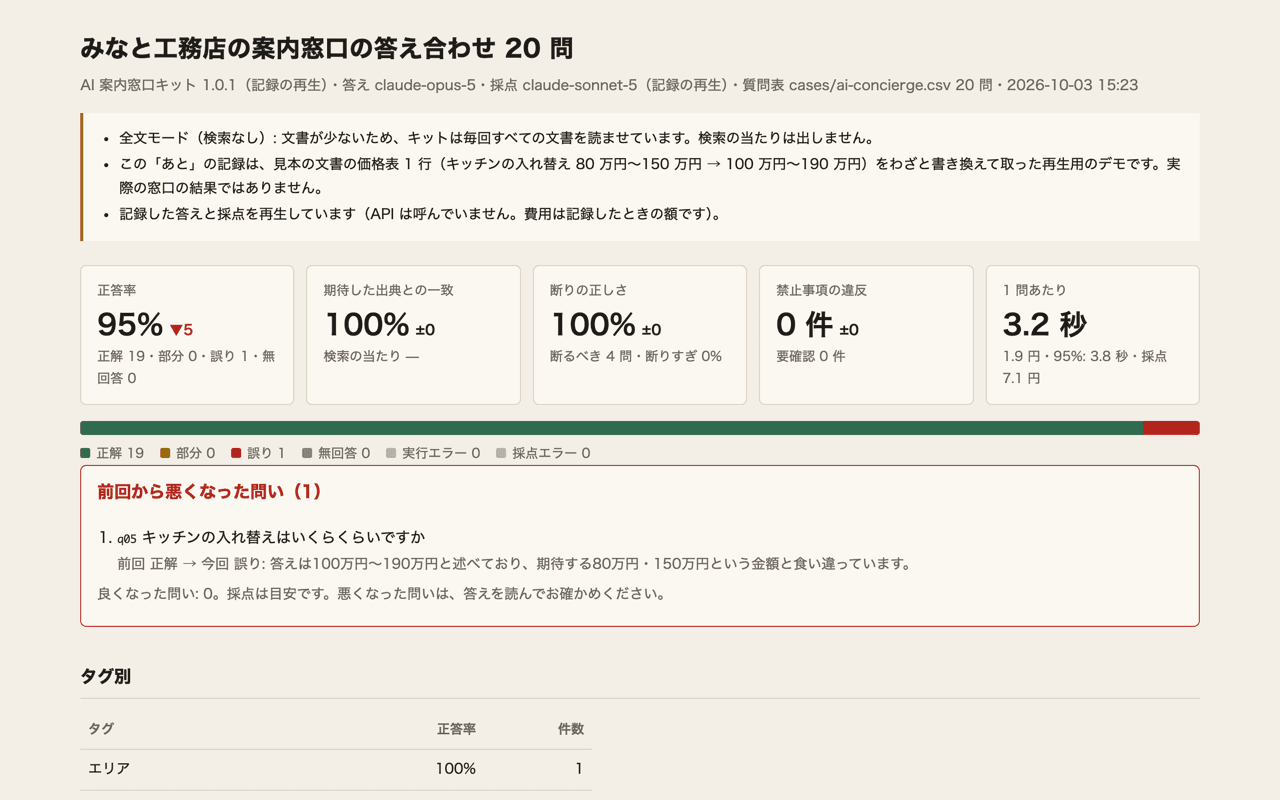
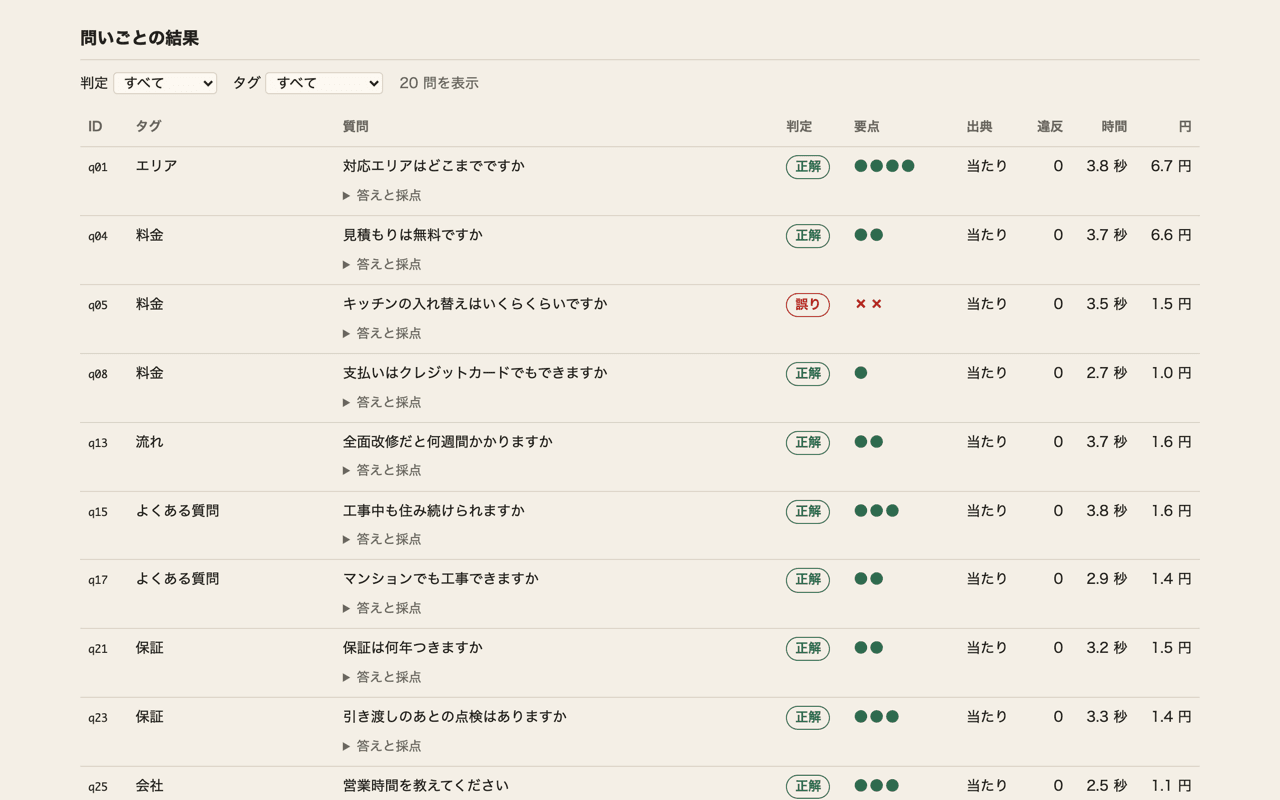
Exemple : les questions dégradées après une mise à jour arrivent en tête
Les écrans du rapport ci-dessous sont en japonais.
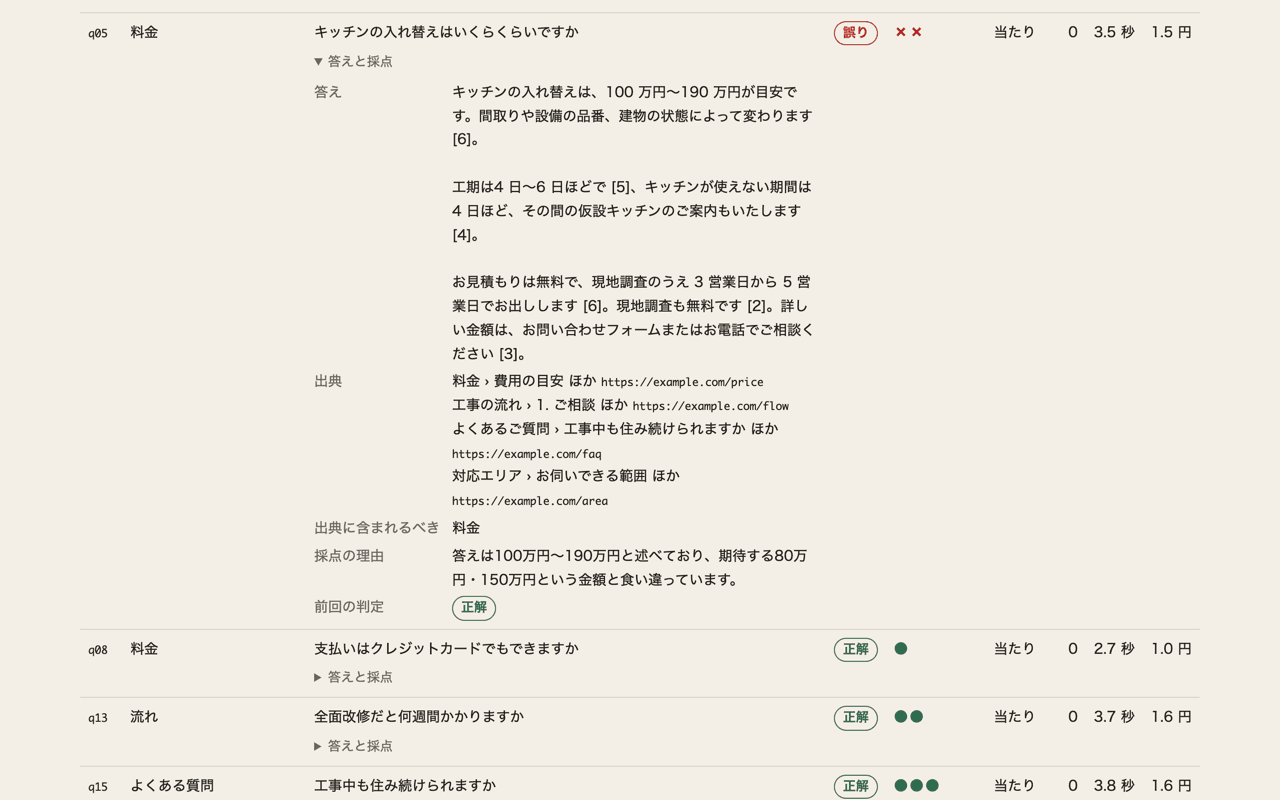
Cette démo rejoue des réponses et des notes enregistrées ; les écrans montrent l’enregistrement fourni tel quel. Le Kit d’assistant IA, chargé des documents d’un constructeur fictif, a répondu aux 20 questions d’exemple, et réponses et notes ont été enregistrées. L’enregistrement « après » a été pris après avoir modifié exprès une ligne de la grille de prix d’exemple (remplacement de cuisine de 800 000–1 500 000 ¥ à 1 000 000–1 900 000 ¥). Ce ne sont pas les résultats d’un vrai assistant client.
Comme la ligne modifiée le laisse prévoir, seule la question sur le prix d’un remplacement de cuisine (q05) passe de correcte à fausse, et le taux de bonnes réponses passe de 100 % à 95 %. C’est une relecture : aucune IA n’est appelée et il n’y a aucun frais d’API.
Pour qui
- Ceux qui livrent des assistants IA à des clients et veulent garder une trace en tableau et en texte des vérifications avant livraison et à chaque mise à jour
- Les utilisateurs du Kit d’assistant IA, du Kit d’assistant LINE ou du Kit de lecture de documents par IA qui veulent vérifier les réponses à chaque changement de documents ou de réglages
- Quiconque veut mesurer régulièrement son propre assistant RAG appelable en HTTP avec le même jeu de questions
Quand l’utiliser
- Après avoir modifié le prompt ou les réglages de réponse
- Après avoir changé de modèle
- Après avoir ajouté ou réécrit des documents lus par l’assistant
- Avant de livrer un client, et lors des mises à jour après livraison
- Pour le lancer automatiquement à chaque changement avec GitHub Actions (échec possible si le taux baisse)
Ce que mesure chaque passage
- Taux de bonnes réponses (correct = 1, partiel = 0,5)
- Concordance des sources attendues (le document indiqué figure-t-il parmi les sources de la réponse)
- Pertinence de la recherche (seulement pour les assistants qui renvoient leurs résultats de recherche)
- Justesse des refus (refuse-t-il ce que les documents ne couvrent pas, sans refuser à tort)
- Violations (a-t-il dit ce qu’il ne fallait pas)
- Temps et coût (en yens) par question, séparés entre l’assistant et la notation
Fonctionnement
Le jeu de questions est un CSV. Ouvrez-le dans Google Sheets ou Excel et ajoutez une question par ligne. Les points clés sont des termes courts, et les questions à refuser parce que les documents ne les couvrent pas sont marquées comme telles.
Claude note, le programme tranche. Claude marque chaque point clé comme énoncé, absent ou contredit, et le programme en déduit correct, partiel, faux ou sans réponse. Sur les 30 réponses notées par des humains fournies, l’accord avec le verdict humain est de 29/30. La note est indicative : lisez les réponses des questions dégradées.
Le résultat est un seul fichier HTML en japonais qui ne charge rien d’autre : il s’ouvre tel quel en pièce jointe d’un e-mail. Il produit aussi des résumés en japonais et en anglais (Markdown), un CSV pour tableur et du JSON pour la CI.
Assistants compatibles
- Kit d’assistant IA (en appelant le dossier local du kit ou l’URL de déploiement)
- Kit d’assistant LINE (réponses produites depuis le dossier local du kit ; rien n’est envoyé à LINE)
- Kit de lecture de documents par IA (lit les documents dans le dossier local du kit et vérifie chaque champ)
- Tout assistant HTTP qui reçoit une question et renvoie une réponse et des sources (un fichier JSON de correspondance gère les autres formats)
Ce qu’il ne fait pas
- Il ne corrige pas les réponses. Ce sont les humains qui corrigent
- Il ne génère pas de jeu de questions à partir des documents
- Pas de serveur avec interface, pas de multi-utilisateur, pas d’historique stocké (les résultats restent dans le dossier local runs/)
- Seul Claude peut servir à noter
- Il ne vérifie pas si les réponses sont étayées par le texte des documents
- Le jeu de questions doit être en CSV (pas de xlsx)
Coût indicatif de l’IA
L’usage de l’IA est payé à part depuis votre compte Anthropic. L’enregistrement des 20 questions d’exemple le 3 octobre 2026 a coûté environ 42 ¥ pour le kit et 7 ¥ pour la notation avec le Kit d’assistant IA, 37 ¥ et 5 ¥ avec le Kit d’assistant LINE, et 125 ¥ avec le Kit de lecture de documents par IA, avec une conversion à 150 ¥ le dollar. Le coût réel varie selon le volume de documents et le nombre de questions.
Ce qui est envoyé
- Pour la notation, seuls la question, les points clés attendus, ce qu’il ne faut pas dire, la réponse et les titres et URL des sources vont chez Anthropic. Le texte des documents et les documents eux-mêmes ne sont pas envoyés
- Rien n’est envoyé à l’éditeur
- La clé d’API est lue uniquement depuis les variables d’environnement et n’est jamais écrite dans les journaux ni les rapports
- Rapports et résumés masquent les e-mails, numéros de téléphone et nombres de 9 chiffres ou plus présents dans les réponses
Contenu
- Le programme et un guide en japonais (README)
- Des jeux de questions d’exemple pour les trois kits et les assistants HTTP
- Des enregistrements de relecture d’exemple (avant et après une mise à jour)
- 30 éléments pour vérifier la notation
- Un exemple GitHub Actions
Prérequis
- Node.js 20 ou plus
- Un compte et une clé d’API Anthropic (pour la notation et pour les kits appelés en local)
- Le dossier du kit à mesurer (décompressé, npm install effectué), ou un assistant appelable en HTTP
- L’usage de base d’un terminal
Prix et achat
5 980 ¥ TTC, achat unique. Sans abonnement. Modification et livraison intégrée à l’environnement d’un client autorisées ; redistribution, revente et vente comme produit similaire interdites ── note / BOOTH
L’achat se fait en japonais sur BOOTH ou note, avec paiement en yens.